1 source · vérifiée le 22 novembre 2026
Les dernières actus
Sources
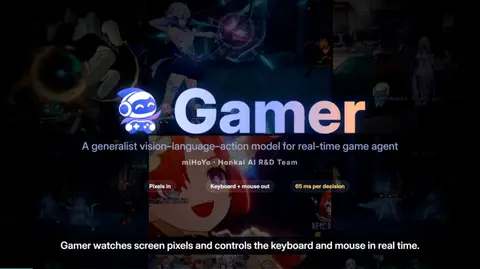
米哈遊發表AI模型「Gamer」代玩《崩壞:星穹鐵道》回合戰鬥與數款小遊戲
更為此開發「Streaming-vLLM」推理引擎
Nature更為此開發「Streaming-vLLM」推理引擎,在 NVIDIA H200 硬體環境下將端到端請求延遲從 1,306 毫秒壓縮至 65.12 毫秒
Nature · Caractéristique
Historique des modifications
- 22 novembre 2026 — Publication : Codex : chaque fait cite une source lue
- 22 novembre 2026 — Fiche vérifiée : Codex : nom et introduction validés, chaque fait cité
- 22 novembre 2026 — Texte rédigé
- 22 novembre 2026 — Affirmation validée
- 22 novembre 2026 — Affirmation proposée
- 22 novembre 2026 — Affirmation validée
- 22 novembre 2026 — Affirmation proposée
- 22 novembre 2026 — Affirmation validée
- 22 novembre 2026 — Affirmation proposée
- 22 novembre 2026 — Création